
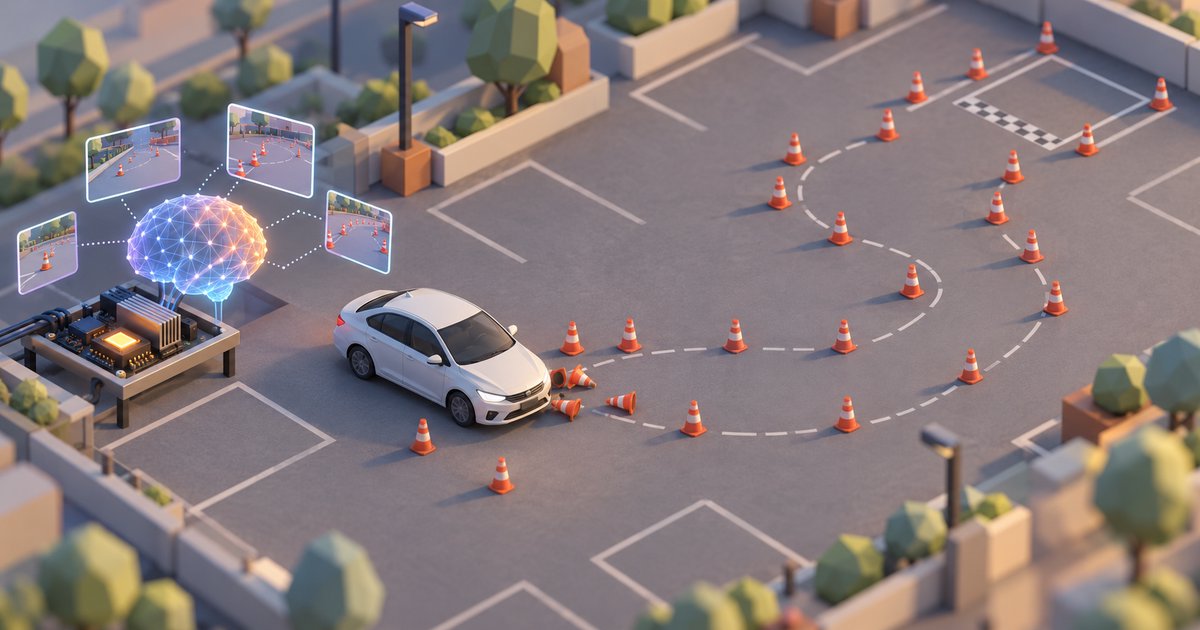
Los investigadores han publicado lo que, según afirman, es el primer benchmark en el que modelos de IA de propósito general conducen un coche real, y el resultado principal es que la mayoría no logró completar un circuito de conos en un aparcamiento.
La prueba
DrivingBench, publicado en arXiv el 30 de septiembre de 2026 por Aditya Ramabadran, Simon Mahns y Tobias Gessler, puso a cuatro modelos de visión y lenguaje de frontera al mando de un Toyota Corolla de 2022 equipado con hardware de comma y openpilot. Los modelos recibieron tres herramientas: una para ver los fotogramas de las cámaras y la telemetría del coche, otra para controlar la dirección y la velocidad, y otra para detenerse.
El circuito era una ruta corta de punto a punto por un aparcamiento, delimitada con conos pequeños, con tramos rectos, curvas, giros a izquierda y derecha y una zona de llegada señalizada. Las velocidades fueron bajas en todo momento.
Una decisión de diseño lo hace más difícil de lo que parece. El coche sigue moviéndose mientras el modelo piensa, y cada nueva orden sustituye a la que todavía está ejecutándose. La latencia de inferencia forma parte de la tarea, en vez de ser algo que el entorno de pruebas oculta: el modelo debe observar, actuar, darse cuenta de que se equivocó y recuperarse, todo mientras el coche avanza.
Los resultados
| Modelo | Resultado |
|---|---|
| GPT-6 Astra | Completó el circuito, en su segundo intento |
| Claude Fable 5.1 | No terminó |
| GPT-5.6 Sol | No terminó |
| Grok 4.6 | No terminó |
Cada modelo tuvo hasta tres intentos en una sola conversación, en el entorno propio de su proveedor: Codex, Claude Code y Cursor. Astra fue el único que terminó, y los autores señalan que ningún otro intento superó el 50% del circuito. De las 11 pruebas, ocho terminaron en accidente y ocho no lograron superar el 11% de la ruta, desmoronándose en la primera curva.
Los fallos individuales enseñan más que el recuento. Grok interpretó un hueco entre conos como una puerta y atravesó por él tras dos órdenes. Un modelo GPT inventó una regla sobre el significado de los colores de los conos y actuó en consecuencia, pese a haber sido advertido explícitamente de lo contrario. Varios sencillamente no giraron lo suficiente. La prueba exitosa de Astra costó $7,74 en inferencia, alrededor de cuatro veces más que los intentos anteriores de medio circuito.
El resumen de los autores es que los modelos de frontera "francamente, no son buenos en esto".
Por qué esta es una historia de Tesla
Porque es la condición de control de un debate que la gente lleva dos años manteniendo sobre FSD.
La postura de Tesla es que conducir requiere una red integral diseñada específicamente para ello, entrenada para la conducción y ejecutándose al ritmo de los fotogramas de las cámaras en el coche. La postura contraria implícita —que los modelos multimodales generales están mejorando lo bastante como para que una pila específica para conducción sea transitoria— ahora tiene una cifra asociada: ocho accidentes en once pruebas con conos en un aparcamiento a paso de peatón. No es un veredicto sobre dónde acabarán los modelos generales; es una medición de dónde están, en un circuito sin otro tráfico, peatones, condiciones meteorológicas ni velocidad.
También recuerda lo que ya estaba haciendo el hardware. El coche utilizaba openpilot, el sistema de comma.ai sobre el que la NHTSA abrió en septiembre una investigación por el mismo patrón de accidentes contra vehículos detenidos que investigó en Autopilot. openpilot conduce ese Corolla perfectamente bien por sí solo. Los modelos no competían contra la ausencia de nada: se les entregaba el volante de un coche que ya tenía un sistema de conducción integrado y, en su mayoría, lo hicieron peor.
Lo que significa en Europa
Esta semana no cambia nada en un coche europeo, pero el benchmark llega en medio de un debate que los reguladores europeos están manteniendo activamente.
El argumento que Tesla y otros presentan ante las autoridades de la UE es que una red entrenada y específica para conducción es auditable de una forma que un modelo de propósito general no lo es: se pueden caracterizar sus modos de fallo, versionarla y probarla frente a un catálogo de escenarios. La gestión del TCMV de la solicitud neerlandesa del artículo 39 —un debate en octubre y una votación no antes de diciembre — es un proceso basado precisamente en ese tipo de documentación.
DrivingBench muestra por qué la distinción se establece ahí. Un modelo que inventa una regla sobre los colores de los conos después de que se le haya dicho que esa regla no existe demuestra el tipo de modo de fallo que la homologación aborda peor: no un error de percepción, sino una inferencia errónea formulada con confianza sin nada que la detecte. La aprobación europea de un sistema de asistencia al conductor es una apuesta por que sus errores sean enumerables. Según esta evidencia, los errores de los modelos generales todavía no lo son.